Google Cloud Computing Services : choisir entre machines virtuelles, serverless et services data
Les services de cloud computing de Google permettent d’héberger une application, de stocker des fichiers, d’analyser des données ou de déployer une intelligence artificielle sans acheter de serveurs physiques. Réunis au sein de Google Cloud Platform, souvent appelée GCP, ils répondent à des besoins différents. Le choix dépend surtout du contrôle technique souhaité, des données à traiter et du budget d’exploitation.
Comprendre ce que Google Cloud prend réellement en charge
Google Cloud est une plateforme de cloud public : Google exploite l’infrastructure physique et met des ressources informatiques à disposition à la demande. Votre équipe les configure depuis une console web, la ligne de commande gcloud, des API REST ou des bibliothèques clientes. La facturation dépend des ressources consommées et des modalités propres à chaque service.
Google Cloud n’est pas Google Drive. Drive sert principalement à conserver et partager des documents. Cloud Storage, par exemple, fournit du stockage d’objets destiné aux applications, aux sauvegardes ou aux traitements de données. Son utilisation implique de définir des accès, une localisation et des règles de conservation.
Le partage des tâches varie selon le modèle retenu. Avec l’IaaS, vous administrez notamment le système d’exploitation de vos machines virtuelles. Avec une plateforme PaaS ou une exécution serverless, davantage de tâches sont prises en charge par Google. Le serverless ne supprime pas les serveurs : il évite surtout d’en gérer directement le provisionnement.
Un service managé agit comme un masque sur la complexité technique : il rend invisibles certaines opérations, sans faire disparaître leurs conséquences. Une base administrée par Google exige toujours de choisir les droits d’accès, les sauvegardes et la stratégie de restauration. Pour chaque service, demandez donc : « Quelles décisions restent à notre charge ? » Cette question révèle souvent mieux le travail réel que l’étiquette « entièrement géré ».
Choisir le moteur d’exécution selon l’application
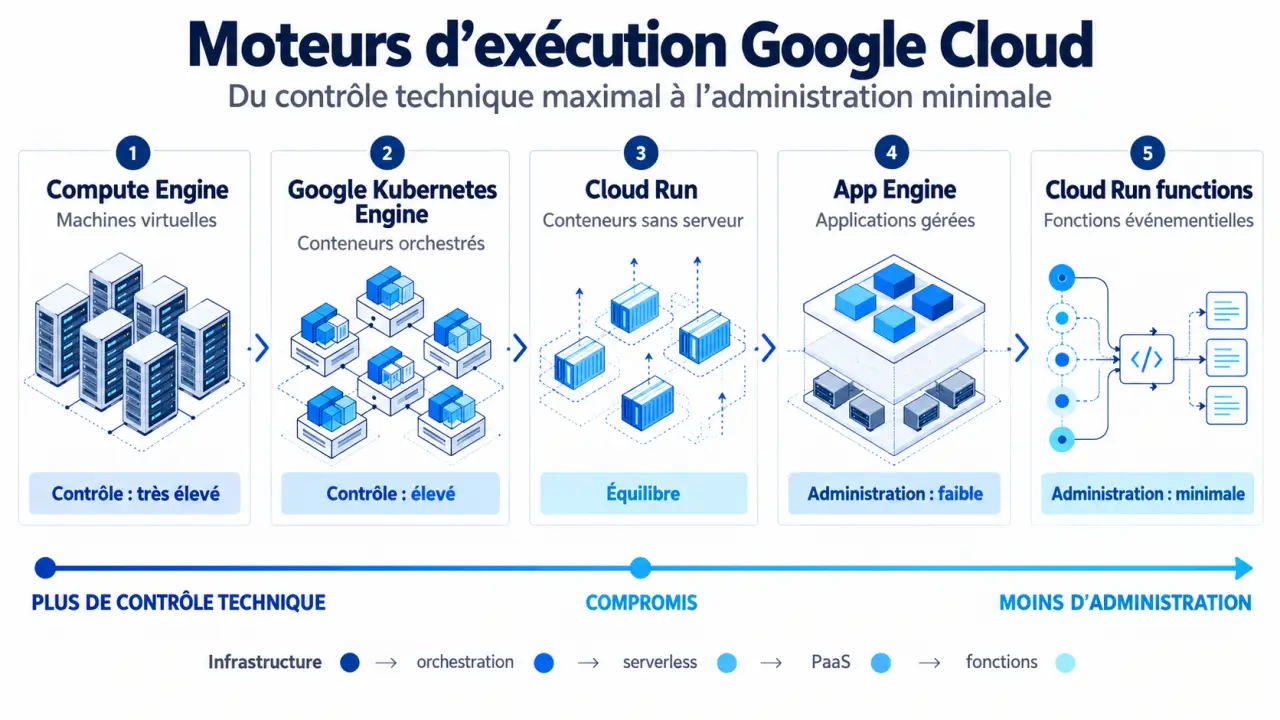
Le bon service de calcul n’est pas nécessairement le plus configurable. Pour une équipe réduite, limiter l’administration peut être plus utile que disposer d’un contrôle complet. À l’inverse, une migration d’application ancienne peut imposer des réglages système précis.
Simulez le coût de vos services Google Cloud — Créez un devis personnalisé en estimant le coût de vos serveurs, de leur puissance et de votre utilisation.
| Service | Usage privilégié | Compromis principal |
|---|---|---|
| Compute Engine | Machines virtuelles, migration d’applications existantes | Contrôle étendu, mais administration du système à prévoir |
| Google Kubernetes Engine, ou GKE | Orchestration d’applications conteneurisées avec Kubernetes | Souplesse, mais compétences Kubernetes nécessaires |
| Cloud Run | Applications web, API et traitements conteneurisés | Peu d’infrastructure à gérer, avec des contraintes d’exécution à vérifier |
| App Engine | Applications déployées sur une plateforme PaaS gérée | Simplicité, mais dépendance aux environnements proposés |
| Cloud Run functions, anciennement Cloud Functions | Fonctions déclenchées par des événements | Adapté aux traitements ciblés, moins à une application monolithique |
Pour une nouvelle API conteneurisée, Cloud Run constitue souvent un point de départ pertinent. GKE se justifie davantage lorsque Kubernetes répond à une exigence concrète : orchestration complexe, pratiques existantes ou contrôle spécifique. Compute Engine convient lorsqu’une application nécessite une machine et son environnement système.
Une application SaaS peut ainsi associer Cloud Run pour son API, Cloud SQL pour ses transactions et Cloud Storage pour les fichiers utilisateurs. Cloud Build automatise les étapes d’intégration et de déploiement, tandis qu’Artifact Registry conserve les images de conteneurs. Cette architecture reste à valider selon le trafic, la disponibilité attendue et les dépendances applicatives.
Organiser les données avant d’ajouter l’analytique et l’IA
Ne pas confondre fichiers, transactions et analyse
Cloud Storage stocke des objets ; Cloud SQL gère des données relationnelles. Le premier convient aux images, exports et sauvegardes. Le second répond aux besoins transactionnels d’une application utilisant une base relationnelle. Firestore propose une base documentaire, tandis que Memorystore fournit un stockage en mémoire, notamment utile pour le cache.
BigQuery répond à un autre besoin : interroger et analyser de grands volumes de données dans un entrepôt serverless. Il ne remplace pas automatiquement la base opérationnelle d’un site marchand. Une architecture peut conserver les commandes dans Cloud SQL, puis alimenter BigQuery pour analyser les ventes sans solliciter la base de production.
Construire une chaîne de traitement cohérente
Pub/Sub transporte des messages et événements entre composants. Dataflow transforme les données par lots ou en flux ; Dataproc fournit des environnements Hadoop et Spark gérés. Cloud Composer orchestre les dépendances et les calendriers des workflows. Ces services sont complémentaires, mais tous ne sont pas nécessaires à chaque projet.
Vertex AI rassemble des capacités de développement, d’entraînement et de déploiement de modèles, y compris pour l’IA générative. Selon le besoin, des approches AutoML, TensorFlow ou des API spécialisées comme Vision et Translation peuvent convenir. Les TPU apportent une accélération adaptée à certaines charges de machine learning. Avant de choisir, vérifiez la qualité des données, les droits d’utilisation et le coût d’inférence : l’accès à un modèle ne garantit pas sa pertinence métier.
Comparer Google Cloud, AWS et Azure sur des contraintes réelles
Les trois plateformes proposent calcul, stockage, bases de données, réseau et intelligence artificielle. Google Cloud mérite notamment une évaluation pour les projets articulés autour de BigQuery, de Vertex AI ou de Kubernetes. AWS et Microsoft Azure doivent être examinés avec les mêmes critères, plutôt qu’à travers un classement général.
- Compétences : quels outils l’équipe sait-elle déjà exploiter et dépanner ?
- Intégration : quels liens faut-il maintenir avec les applications, identités et contrats existants ?
- Localisation : les services nécessaires sont-ils disponibles dans les régions compatibles avec vos obligations ?
- Coût complet : combien coûtent le calcul, le stockage, les transferts, le support et l’exploitation humaine ?
- Réversibilité : quelles données et fonctionnalités seraient difficiles à déplacer ?
Une région correspond à une implantation géographique ; ses zones permettent de répartir certaines ressources. Choisir une région proche des utilisateurs peut réduire la latence, mais ne suffit pas à assurer la conformité ou la résilience. Il faut aussi examiner les engagements contractuels, les sauvegardes et les scénarios de panne.
Côté connectivité, un VPC structure le réseau privé, Cloud CDN diffuse les contenus et Cloud VPN relie des environnements par tunnel sécurisé. Des interconnexions privées peuvent répondre à des besoins hybrides plus exigeants. Leur intérêt dépend des volumes, de la latence attendue et du coût des liaisons.
Démarrer avec un budget, des accès limités et un test représentatif
Google Cloud propose des crédits de démarrage de 300 $ ; KERN-IT mentionne une durée de 90 jours. Vérifiez les conditions d’éligibilité et les modalités en vigueur avant l’inscription. Ces crédits facilitent un essai, mais ne représentent pas le coût futur d’une production.
Estimez séparément le calcul, les bases de données, le stockage, les requêtes analytiques, les journaux et les transferts sortants. Testez ensuite un scénario courant et un pic d’activité. Des remises sur engagement peuvent réduire certains coûts prévisibles ; elles sont moins adaptées à une charge encore mal connue. Une alerte budgétaire ne constitue pas un plafond automatique de dépense.
- Créez le compte, configurez la facturation et choisissez une région adaptée.
- Séparez les trois environnements : développement, staging et production, idéalement dans des projets distincts.
- Attribuez avec IAM les rôles strictement nécessaires et protégez les secrets.
- Déployez un périmètre réduit via la console, gcloud ou Terraform pour rendre l’infrastructure reproductible.
- Activez Cloud Monitoring et Cloud Logging ; utilisez Cloud Trace pour investiguer les parcours applicatifs.
- Testez les sauvegardes, la restauration et la suppression des ressources inutilisées.
Un accompagnement devient pertinent pour une migration critique, des exigences réglementaires ou une équipe sans expérience d’exploitation cloud. Demandez des livrables précis : architecture, estimation des coûts, règles de sécurité, procédure de reprise et transfert de compétences. L’objectif reste de pouvoir exploiter la plateforme durablement, pas seulement de réussir son premier déploiement.